Die Identitätskrise der KI – Teil 03
3. Die Entwicklung der KI: Von Expertensystemen zum Deep Learning
Autor: Matthias Bühler
Redaktor: Johannes Herold
Expertensysteme versuchten, die Entscheidungsfindung von Fachleuten nachzubilden, indem Wissen als explizite Regeln kodiert wurde, die Computer ausführen konnten. Allerdings wiesen diese Systeme grundlegende Beschränkungen auf.
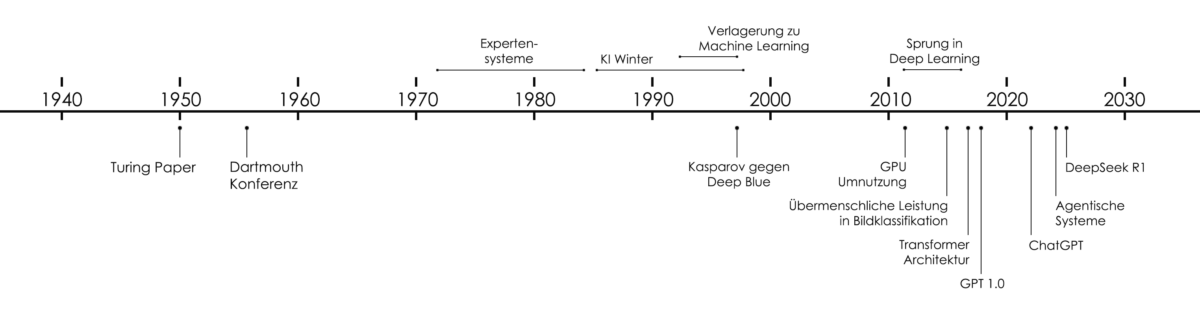
In den 1970er- und 1980er-Jahren konzentrierte sich die KI-Forschung auf Expertensysteme. Diese versuchten, die Entscheidungsfindung von Experten nachzubilden, indem Wissen als explizite Regeln kodiert wurde, die Computer ausführen konnten. Man könnte sagen, dass diese Systeme komplexe, regelbasierte und vollständig deterministische „if/else“-Algorithmen darstellten. Ein Bauingenieur, Geologe oder Architekt konnte sein Fachwissen in Regelsätze übersetzen, die Maschinen konsistent und zuverlässig anwenden konnten.
Beispiele solcher Expertensysteme:
- „BDES – Bridge Design Expert System“, 1987, Duke University, Durham, North Carolina, USA
- „CONSTRUCTION PLANEX“, 1987/1988, Carnegie Mellon University, Pittsburgh, Pennsylvania, USA
- „HI-RISE – Structural Design Expert System“, 1985, Carnegie Mellon University, Pittsburgh, Pennsylvania, USA
Dieser Ansatz erzielte in bestimmten Bereichen echte Erfolge, beispielsweise bei der Diagnose von Geräteausfällen und der Unterstützung von Ingenieuren. Allerdings wiesen diese Systeme grundlegende Beschränkungen auf. Expertensysteme waren anfällig: Sie leisteten innerhalb ihrer „trainierten“ Bereiche hervorragende Arbeit, versagten jedoch katastrophal, wenn sie auf Situationen stiessen, die ausserhalb ihres kodierten Wissens lagen. Sie erforderten ständige Wartung und waren nicht in der Lage, zu lernen oder sich anzupassen.
Die Starrheit und Inflexibilität von Expertensystemen trugen dazu bei, dass das Interesse an KI und die Investitionen in diesen Bereich in den 1980er Jahren und bis in die 1990er Jahre hinein nachliessen – eine Zeit, die als „KI-Winter“ bekannt ist (ohne zu sehr ins Detail zu gehen: Es gab genau genommen zwei KI-Winter). Dieser Rückgang spiegelte die tatsächlichen technischen Grenzen des regelbasierten Ansatzes zur Intelligenz wider. Er prägte zudem ein Muster: Wenn eine bestimmte Ausprägung der „KI“ die überzogenen Versprechungen nicht einhalten konnte, griff Skepsis auf das gesamte Fachgebiet über. Geschichte wiederholt sich typischerweise.
Der Paradigmenwechsel zum maschinellen Lernen
Ab den 1990er Jahren und mit zunehmender Dynamik in den 2000er Jahren verlagerte sich die KI-Forschung allmählich von regelbasierten Systemen hin zum maschinellen Lernen. Anstatt zu versuchen, menschliches Fachwissen durch explizite Regeln abzubilden, sind Systeme des maschinellen Lernens darauf spezialisiert, Muster direkt aus Daten zu erkennen. Dies ermöglicht es Klassifikatoren, Kategorien durch die eigenständige Erkennung statistischer Muster anstelle expliziter Regeln zu unterscheiden und aus Beispielen auf neue, bisher unbekannte Fälle zu verallgemeinern.
Dieser Wandel vollzog sich parallel zu einem exponentiellen Anstieg der Rechenleistung und der Datenverfügbarkeit. Das Internet stellte beispiellose Mengen an Text, Bildern und anderen Daten bereit, die Algorithmen des maschinellen Lernens für das Training nutzen konnten. Grafikprozessoren (GPUs), die ursprünglich für Spiele und die Echtzeit-Grafikwiedergabe mit massiv parallelisierten Hardwarearchitekturen entwickelt wurden, erkannten KI-Forscher als ideal für das Training grosser neuronaler Netze an: Eine Umnutzung, die ab etwa 2012 zu bedeutenden Durchbrüchen im Deep Learning (einem Teilbereich des maschinellen Lernens) führte. Technologien wie NVIDIA CUDA und das Aufkommen des Cloud-Computing machten diese Ressourcen weltweit zugänglich und ermöglichten so hochentwickelte Systeme und einen sich beschleunigenden Fortschritt. Dieselben technologischen Fortschritte trieben auch völlig andere Branchen mit hohem Rechenaufwand voran, wie beispielsweise das Blockchain-basierte Mining von Kryptowährungen (für weitere Informationen suchen Sie nach „SHA-256“).
Die Begriffsverwirrung vertiefte sich: Nun konnte der Begriff „KI“ jedes System bezeichnen, das aus Daten lernte, unabhängig von seiner Komplexität.
Dieser Wandel führte zu neuen Verwirrungen darüber, was KI eigentlich bedeutete. Maschinelles Lernen unterscheidet sich von Expertensystemen, doch beide wurden (wieder) als KI bezeichnet. Der unterschiedliche Ansatz wurde manchmal als fortschreitende Entwicklung hin zu „echter Intelligenz“ dargestellt, doch die Wahl des Begriffs war eher eine pragmatische Entscheidung, die auf technischen Möglichkeiten beruhte, als auf einem tieferen Verständnis von Intelligenz an sich. Die Unklarheit in der Terminologie vertiefte sich: Nun konnte sich der Begriff „KI“ auf jedes System beziehen, das aus Daten lernte, unabhängig von seiner Komplexität. Einige wegweisende Anwendungen fanden Eingang in generatives Architekturdesign im Jahr 2001, wie beispielsweise das Tool „Kaisersrot“ (verbunden mit dem Lehrstuhl für CAAD von Prof. Ludger Hovestadt an der ETH Zürich), und wurden erfolgreich für reale Projekte eingesetzt.
Die Deep-Learning-Revolution und die heutige Verwirrung
Deep Learning in den 2010er Jahren, angetrieben durch Fortschritte bei den Architekturen neuronaler Netze und die Verfügbarkeit riesiger Datensätze, markierte einen bedeutenden technischen Sprung. Tiefe neuronale Netze konnten hierarchische Darstellungen generischer Daten erlernen – wobei untere Schichten einfache Merkmale erkannten und höhere Schichten diese zu Abstraktionen von allmählich zunehmender Komplexität zusammenfassten, was zu dramatischen Verbesserungen in den Bereichen computergestützter Bilderkennung, Verarbeitung natürlicher Sprache, Robotik und anderen Gebieten führte. Ihr Erfolg löste einen neuen Investitionsschub und Optimismus hinsichtlich der Fähigkeiten der KI aus.
Ein wichtiges technisches Detail zum Verständnis der Natur neuronaler Netze ist, dass ihre Struktur und die von ihnen verarbeiteten Daten bewusst aufeinander abgestimmt sind. Die „magische Verbindung“ zwischen beiden ist die Minimierung der sogenannten „Verlustfunktion“, bei der es sich (wörtlich) um eine mathematische Funktion handelt, die die Qualität eines Ergebnisses misst. Das Ziel des Trainingsprozesses besteht darin, „den Verlust“ über alle möglichen Ausgaben hinweg zu minimieren. Beim Reinforcement Learning (RL) ist der gesamte Trainingsaufbau als eine Art „Belohnungssystem“ konzipiert, bei dem das System Anreize erhält, Wege zu guten Ergebnissen zu erkunden. Es ist zwar nicht üblich, aber es könnten auch komplexere „Belohnungs-Bestrafungs-Systeme“ entworfen werden, bei denen schlechte Wege gezielt vermieden werden. Die (bestmögliche) Definition der Verlustfunktion ist oft eine der grössten Herausforderungen beim Systemdesign. Insbesondere im Zusammenhang mit Anwendungen neuronaler Netze in Architektur und Kunst kehren wir zu der jahrhundertealten Frage zurück: Wie lässt sich Schönheit mathematisch quantifizieren? Das entbehrt nicht einer gewissen Ironie, oder?
Es wird deutlich, dass die Verarbeitung grosser Datenmengen – darunter Text, Musik, tabellarische Werte und Bilder (die einfach als rasterbasierte Datentabellen betrachtet werden können) – mithilfe massiver Parallelisierung auf GPUs rasante Fortschritte in den Bereichen Computer Vision und Computergrafik vorangetrieben hat.
Es fühlt sich wie Intelligenz an.
Und wieder brachte dieser Erfolg neue Verwirrung mit sich. Als ein Modell 2015 bei der Bildklassifizierung über-menschliche Leistungen erzielte: War es wirklich intelligent? Verstand es visuelle Konzepte oder führte es lediglich ausgefeilte statistische Mustererkennung anhand von Pixelwerten durch? Kurz gesagt: Nein. Es ist keine Echte Intelligenz im Spiel. Aber: Ohne alle technischen Details zu kennen, wie diese Systeme funktionieren, ist die Vorstellung, dass „es sich wie Intelligenz anfühlt“, eine völlig berechtigte Wahrnehmung, da die natürlichen, intuitiven Emotionen eines Menschen dessen Realität sind.
Diese Bedenken spielen (aus technischer Sicht) für den praktischen Einsatz eine untergeordnete Rolle, sind jedoch entscheidend für das Verständnis der Öffentlichkeit und für organisatorische Entscheidungen über den Einsatz von KI. Im Kontext der Kunst und der „Creatio Artis“ ist genau dieser semantische Unterschied von grösster Bedeutung. Diese Dynamik werden wir in einem anderen Artikel untersuchen.
Die Entwicklung der „Transformer-Architektur“ im Jahr 2017 (siehe Fachartikel „Attention Is All You Need“, von Google Research) ermöglichte einen qualitativen Sprung in der Sprachmodellierung und schuf die technische Grundlage für moderne Large Language Models (LLMs). Die GPT-Modellfamilie begann 2018 mit GPT-1 und 2019 mit GPT-2 und erreichte mit der Einführung von ChatGPT (unter Verwendung von GPT-3.5) im November 2022 eine breite öffentliche Resonanz. Diese Modelle, die auf riesigen Textmengen trainiert wurden, konnten bemerkenswert kohärente Texte generieren, Fragen beantworten und Gespräche führen. Während viele davon begeistert waren, fragten sich andere, ob eine solche Textgenerierung (egal wie fortschrittlich sie auch sein mag) echte Intelligenz oder echtes Verständnis darstelle. Die Mehrdeutigkeit in Turings ursprünglicher Formulierung – dass Intelligenz möglicherweise nicht von einer überzeugenden Simulation zu unterscheiden sei – hat sich von einer philosophischen Kuriosität zu einem dringenden praktischen Problem und einer Debatte gewandelt.
Fortsetzung folgt.